
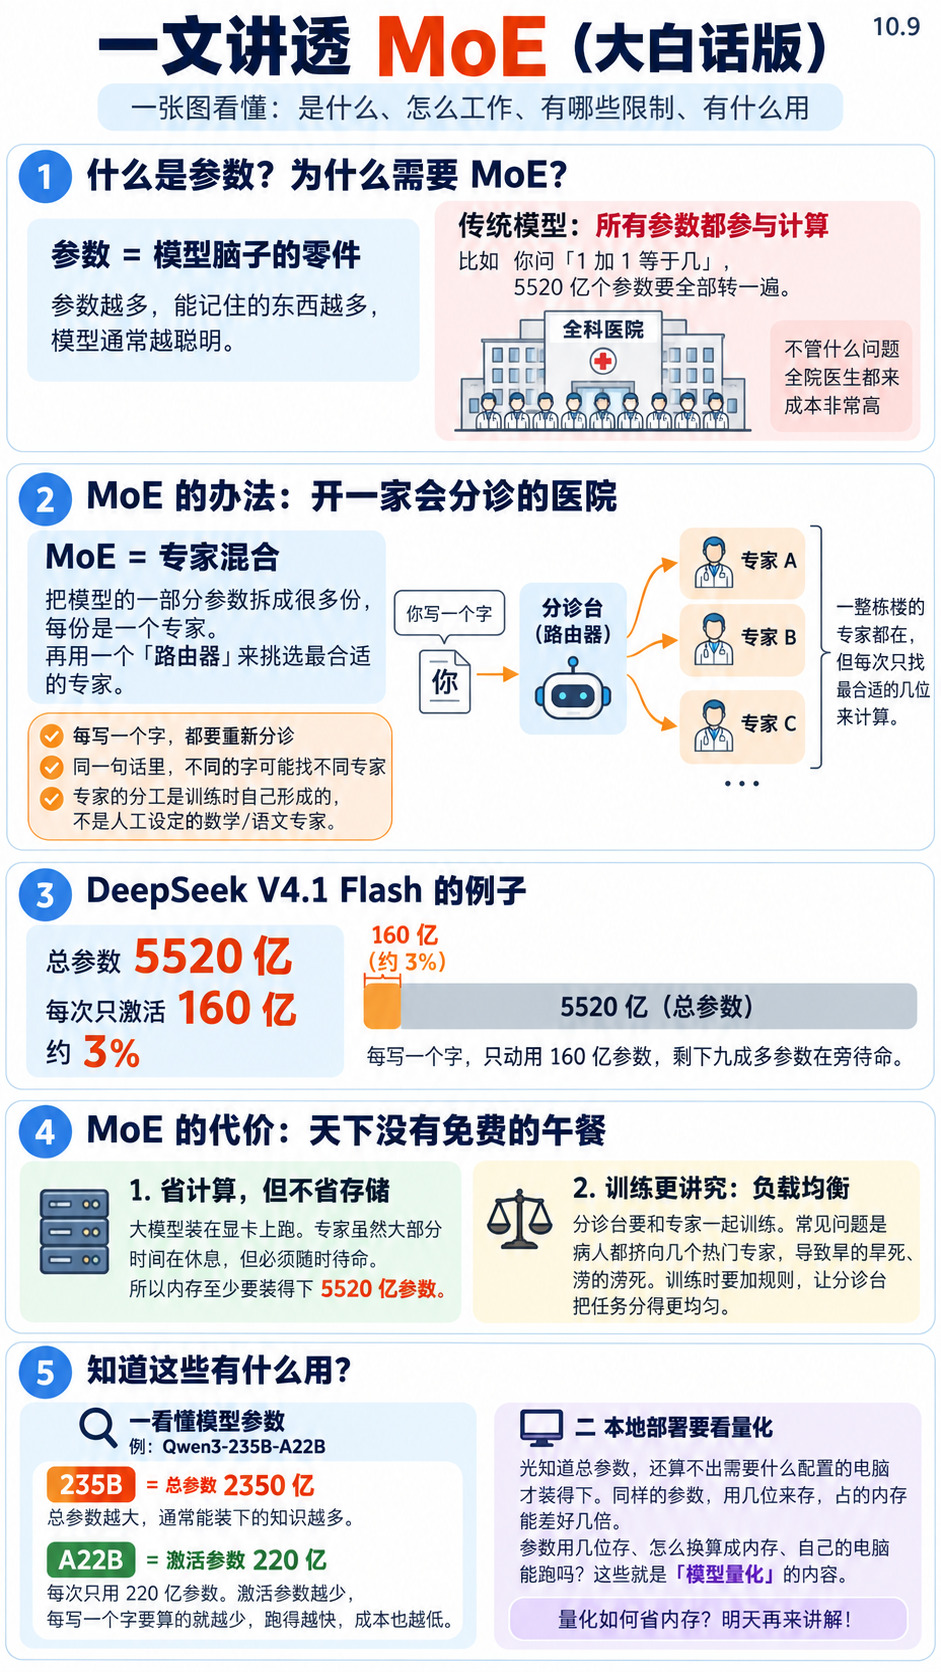
一文讲透 MoE(大白话版)
去年 3 月,日课聊过 MoE,也就是专家混合架构。一年多过去,很多人还是不太清楚它到底是怎么回事,今天换个角度,重新讲一遍。
AIAI基础知识AI模型DeepSeekGPU
围绕 AI 工作流、Agent 设计和内容系统的每日更新。
去年 3 月,日课聊过 MoE,也就是专家混合架构。一年多过去,很多人还是不太清楚它到底是怎么回事,今天换个角度,重新讲一遍。
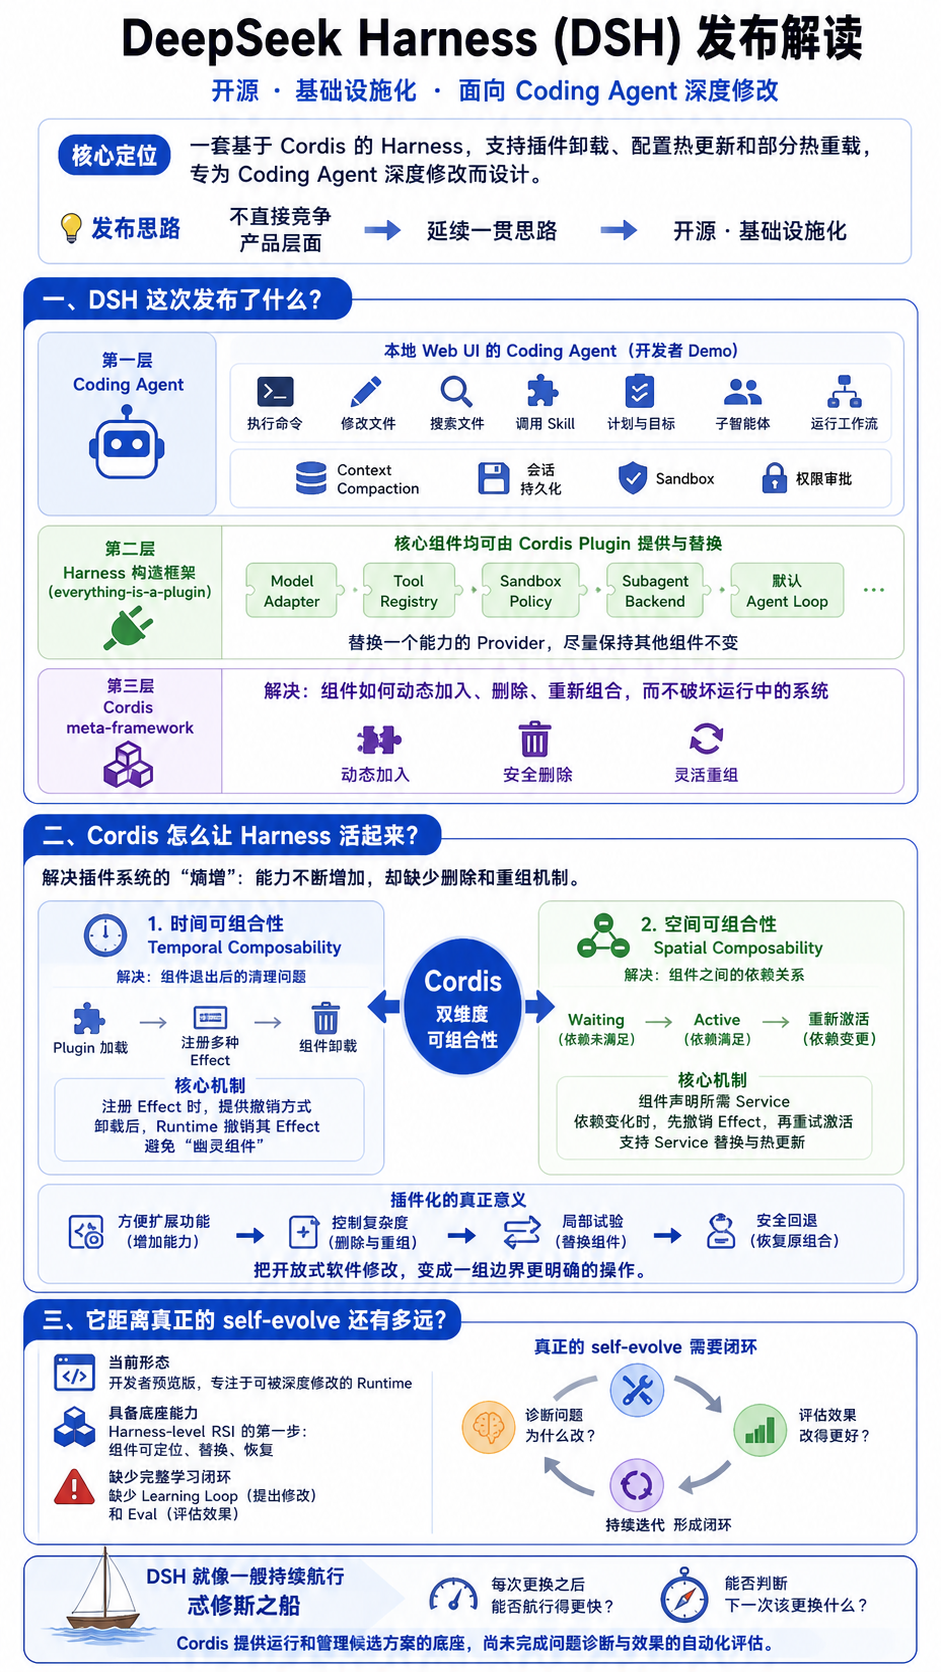
DeepSeek Harness 发布的是一套基于 Cordis、支持插件卸载、配置热更新和部分热重载的 Harness,并且被设计成适合 Coding Agent 深度修改的形态。
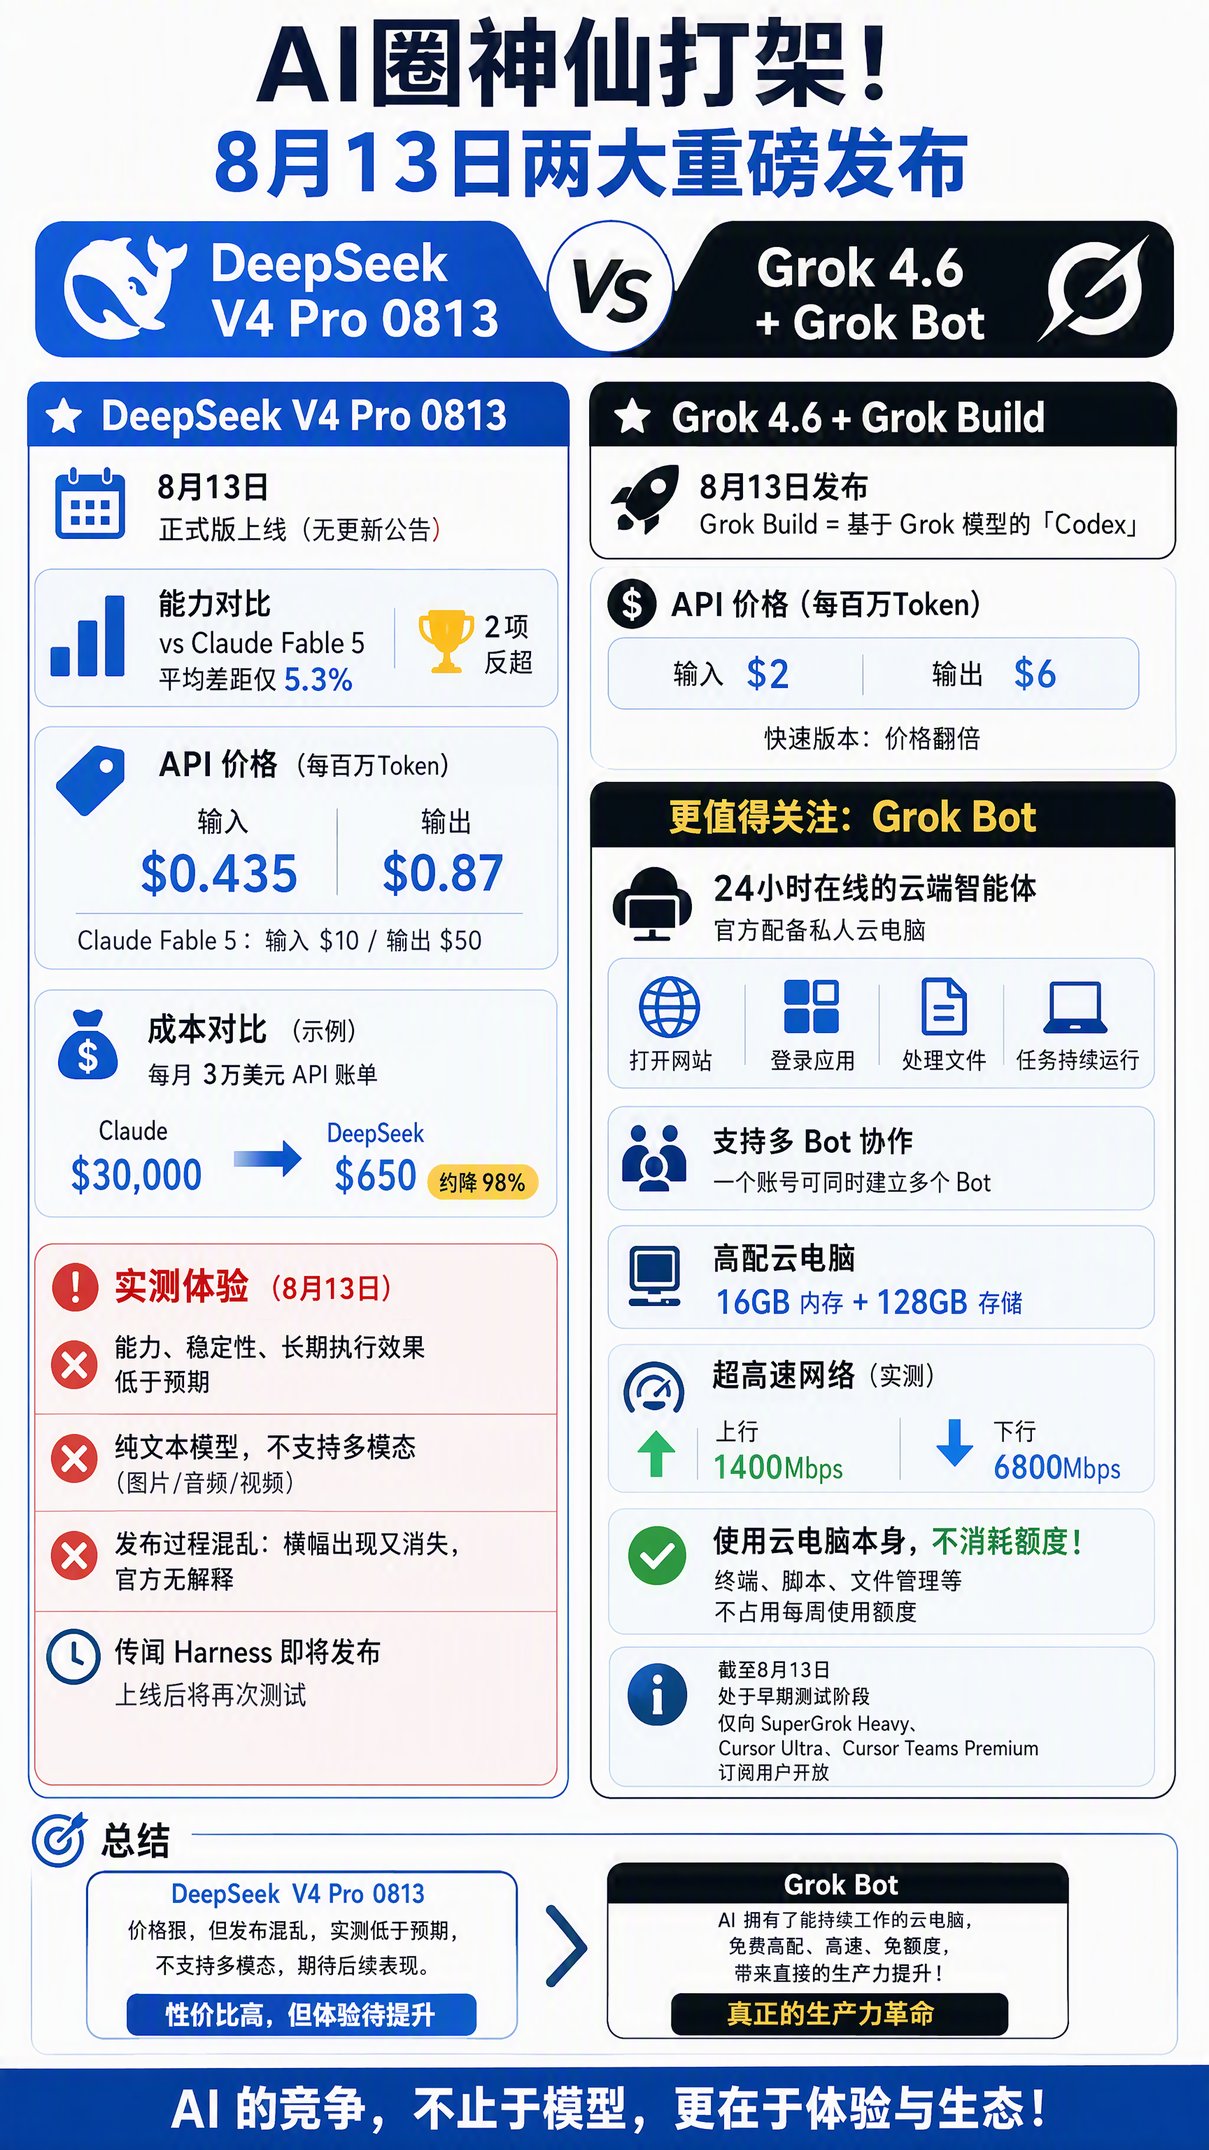
按北京时间,8月13日,DeepSeek V4 Pro的0813版本和Grok 4.6几乎同时上线。DeepSeek这边像是一次没准备好的发布,Grok同期推出的Bot却直接给智能体配了台常驻云电脑。
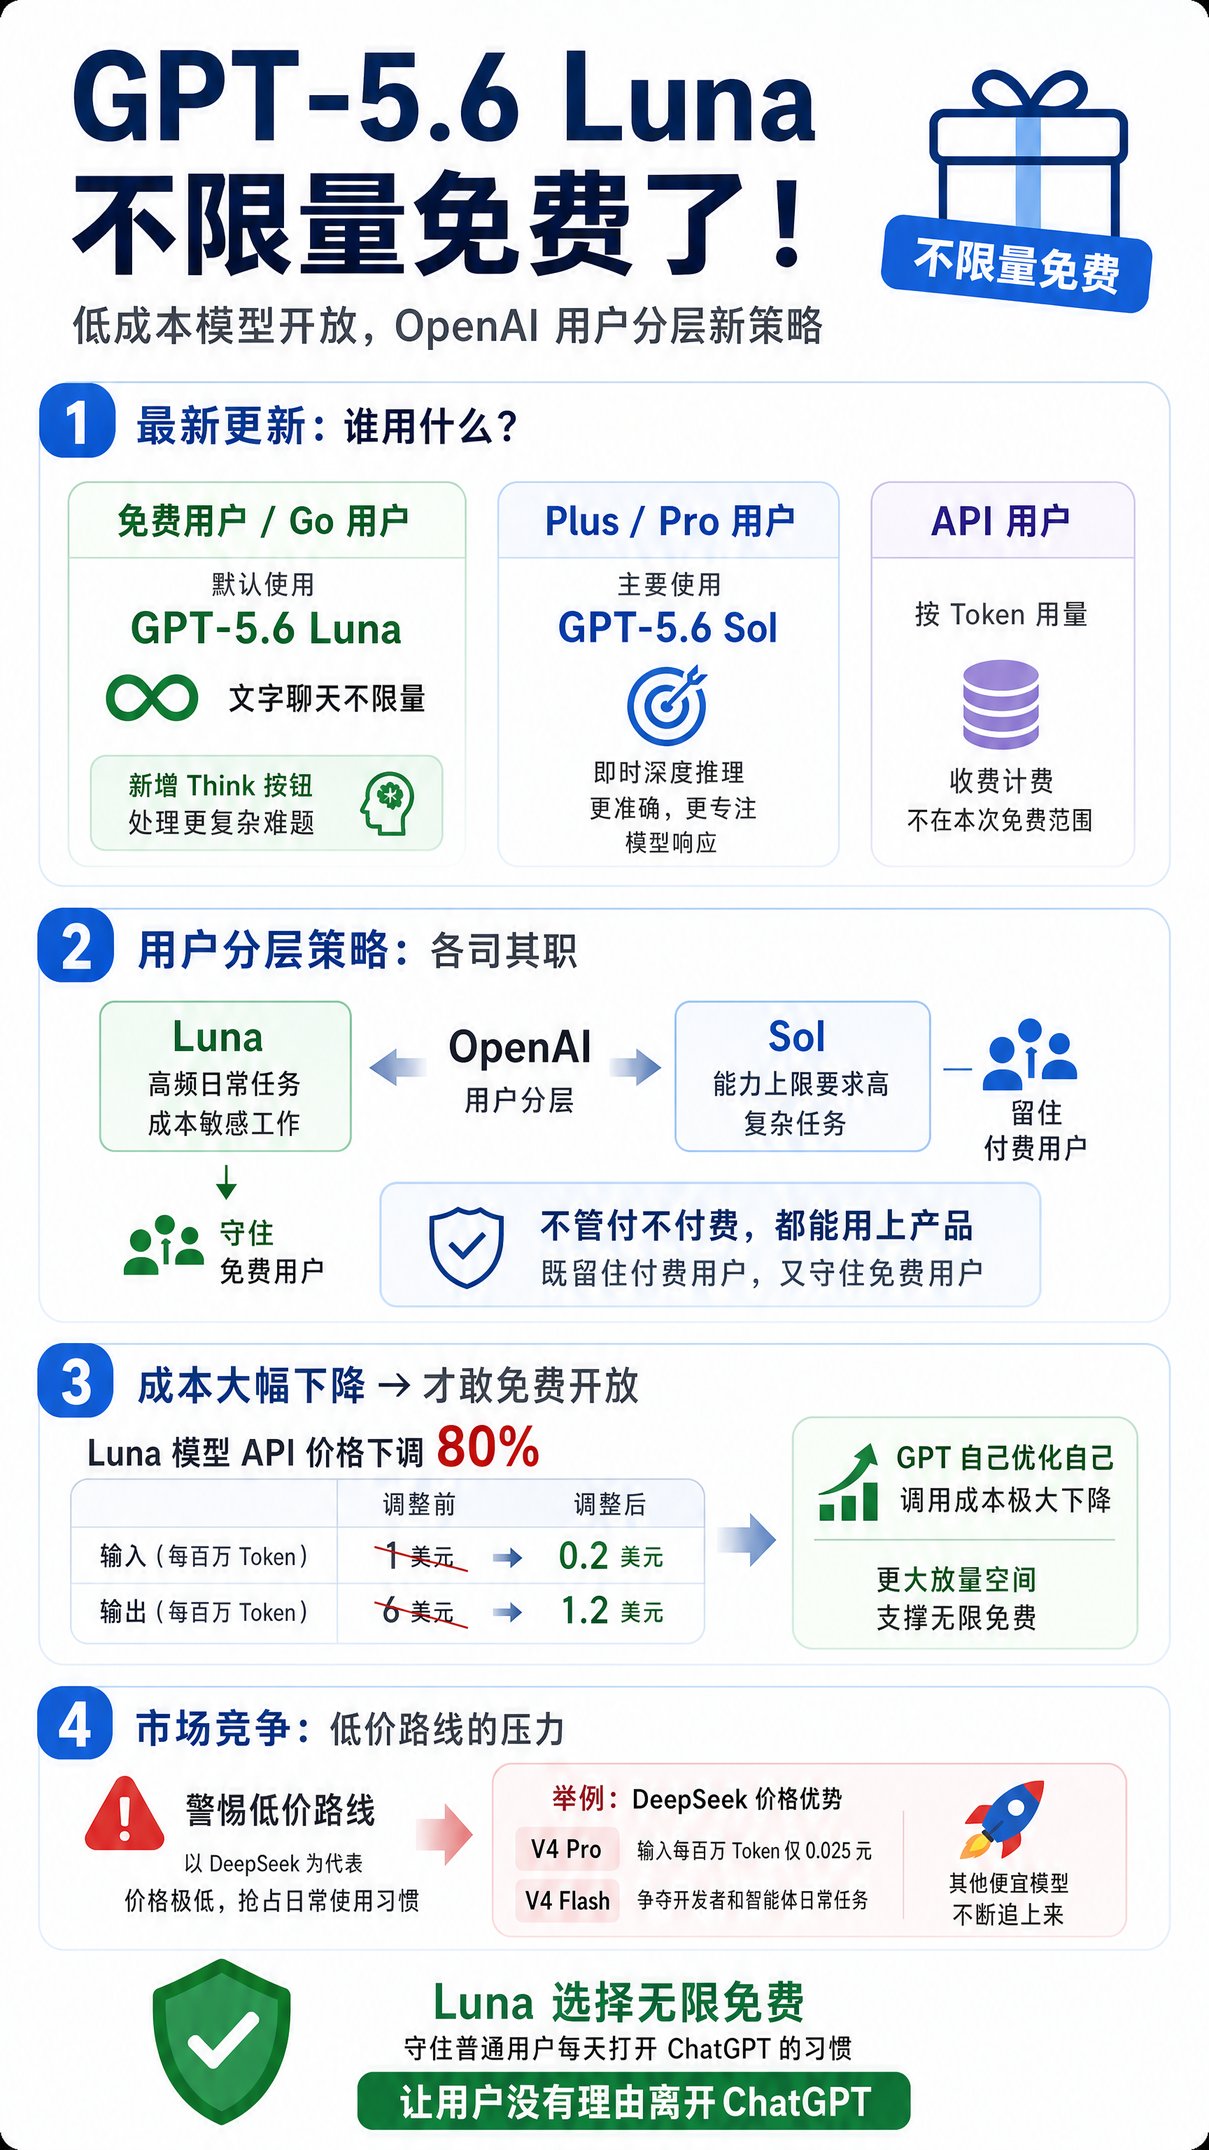
OpenAI这次也开始害怕了。8月6日,OpenAI突然宣布,GPT-5.6 Luna将向免费用户开放无限文字聊天。这显然不只是在发福利。
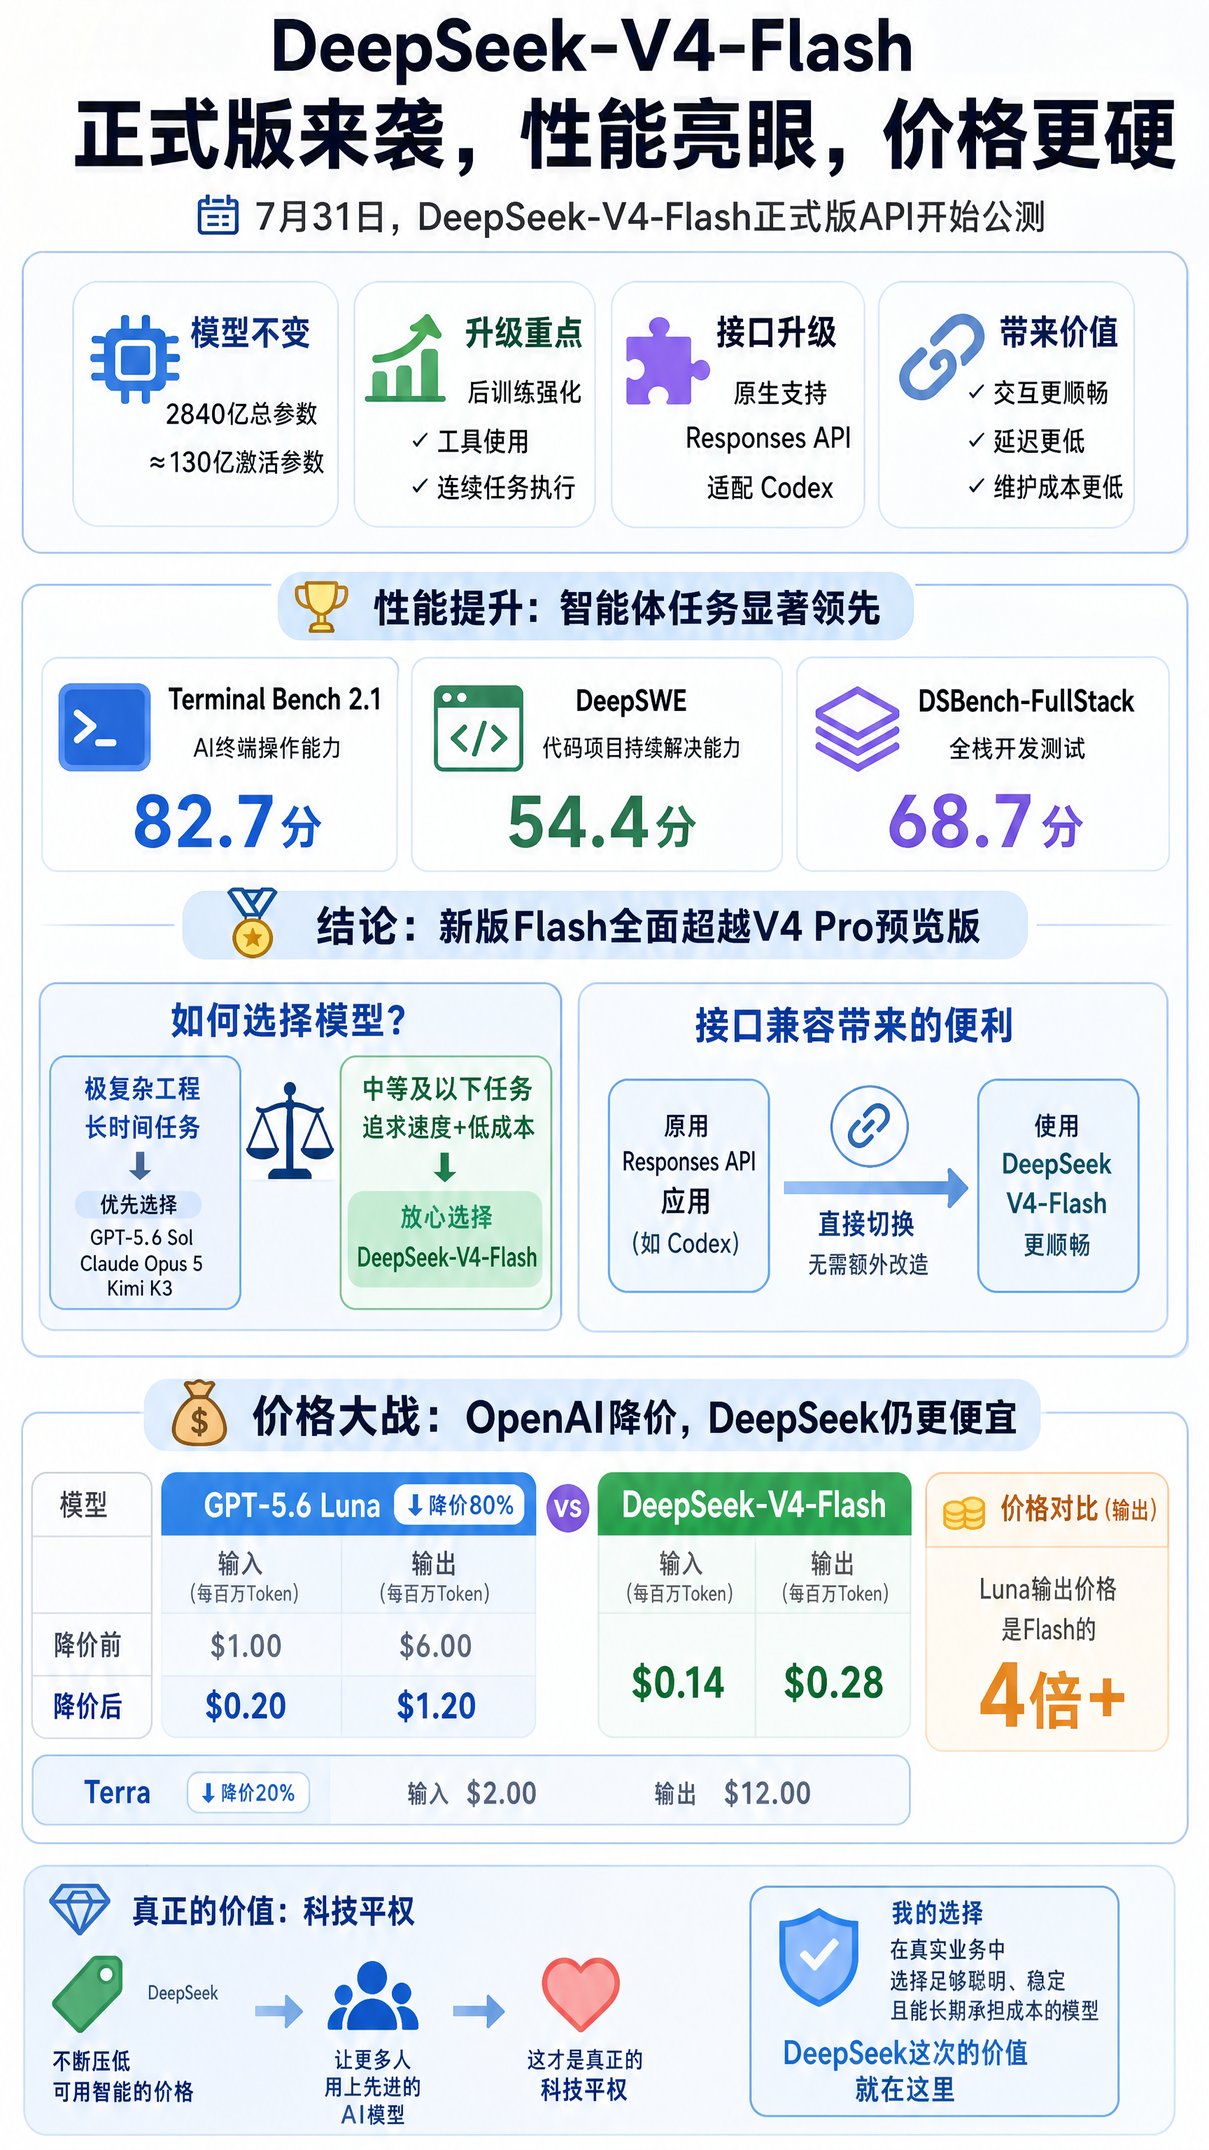
DeepSeek终于把V4系列往正式版推进了一步。7月31日,率先更新的是DeepSeek-V4-Flash API。
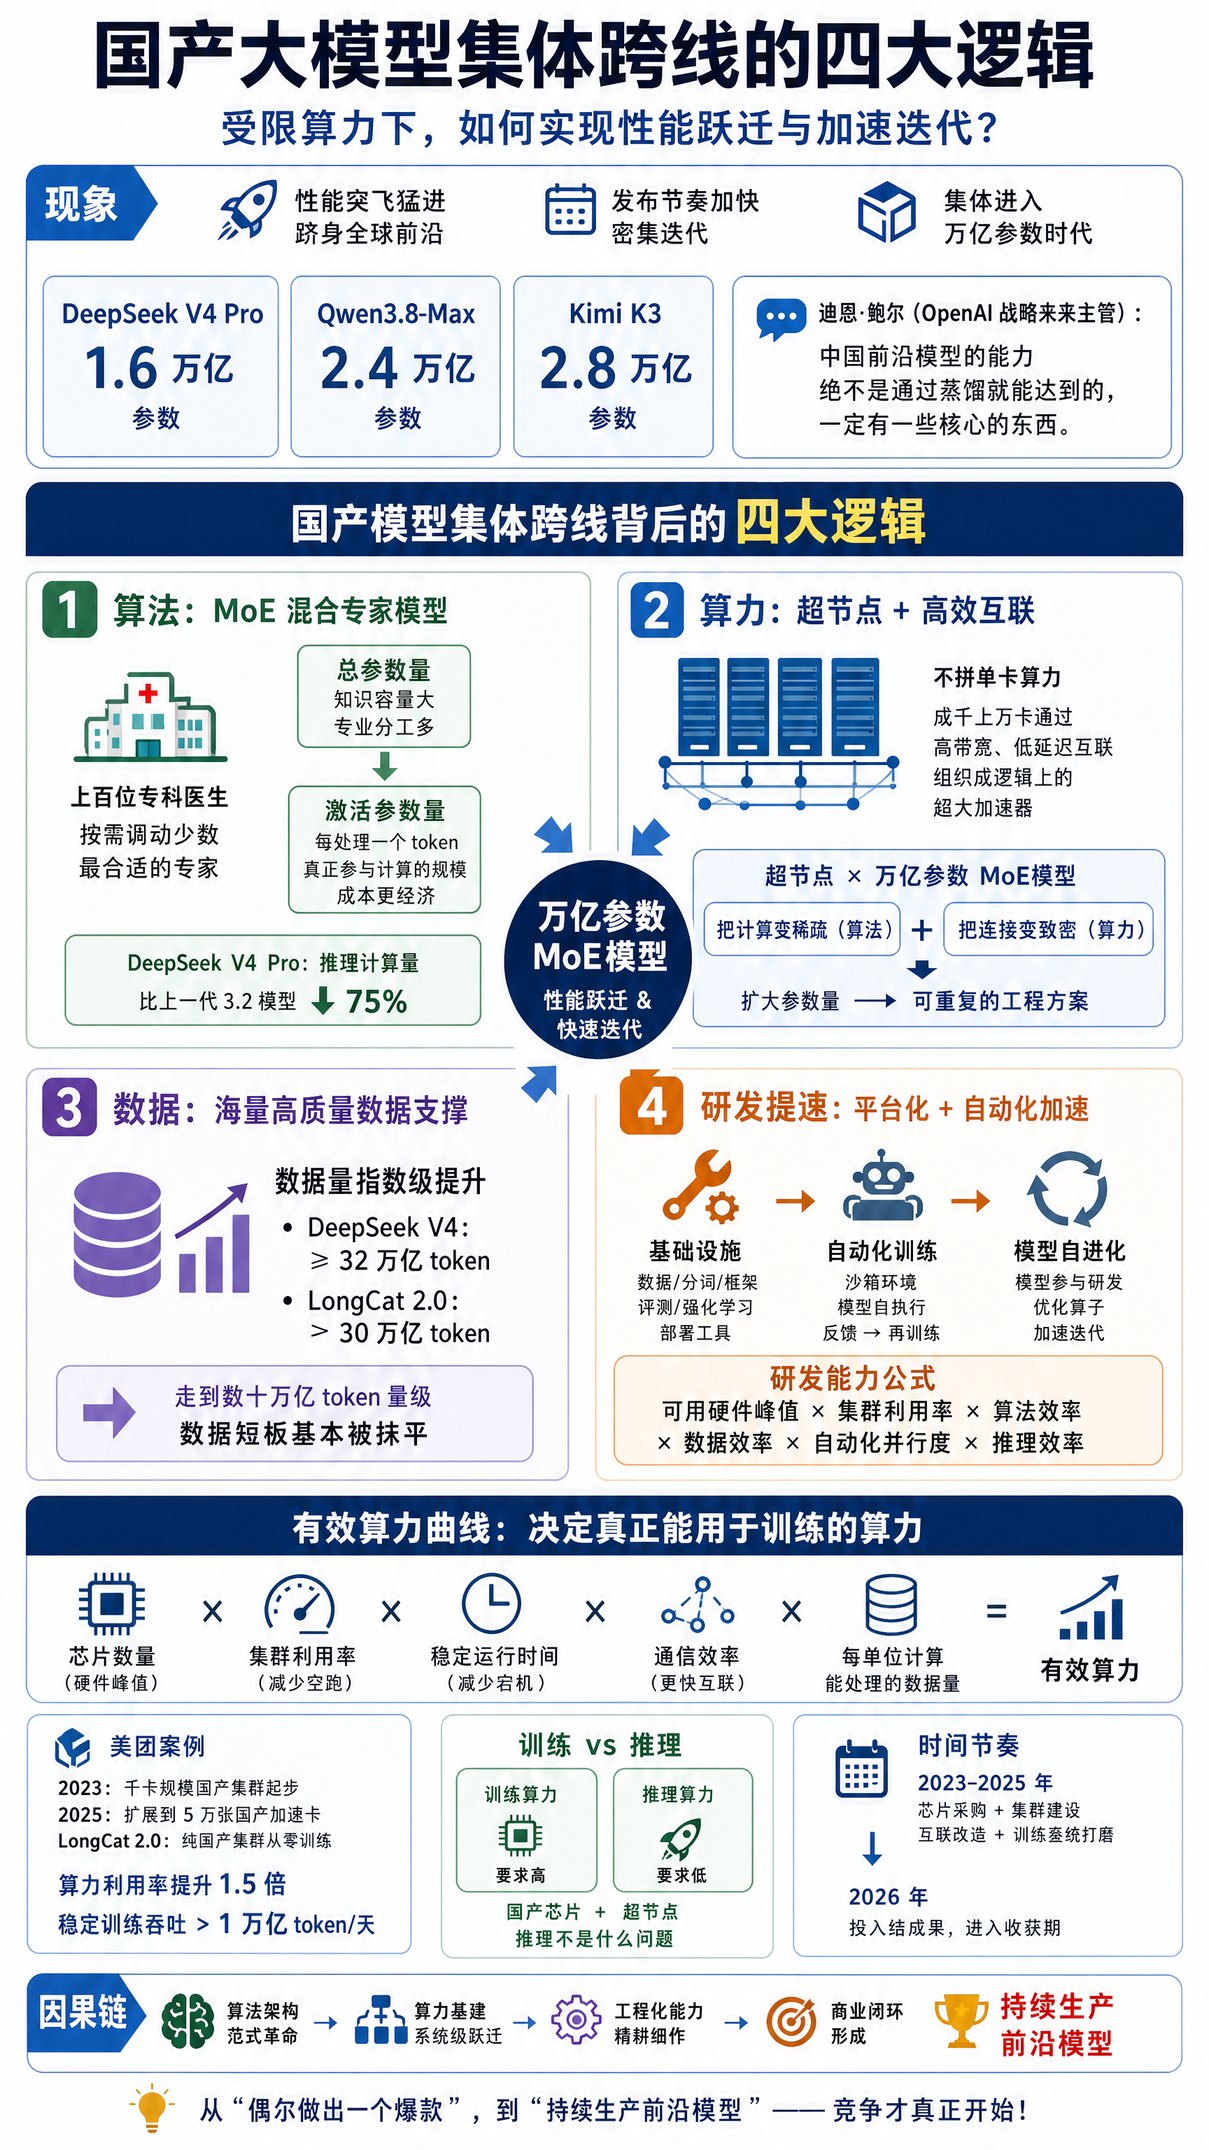
明明是先进算力受限的一方,国产模型却集体跨进万亿参数时代,能力逼近全球前沿。背后是算法架构、算力基建、工程化和商业闭环四条逻辑的乘法效应。

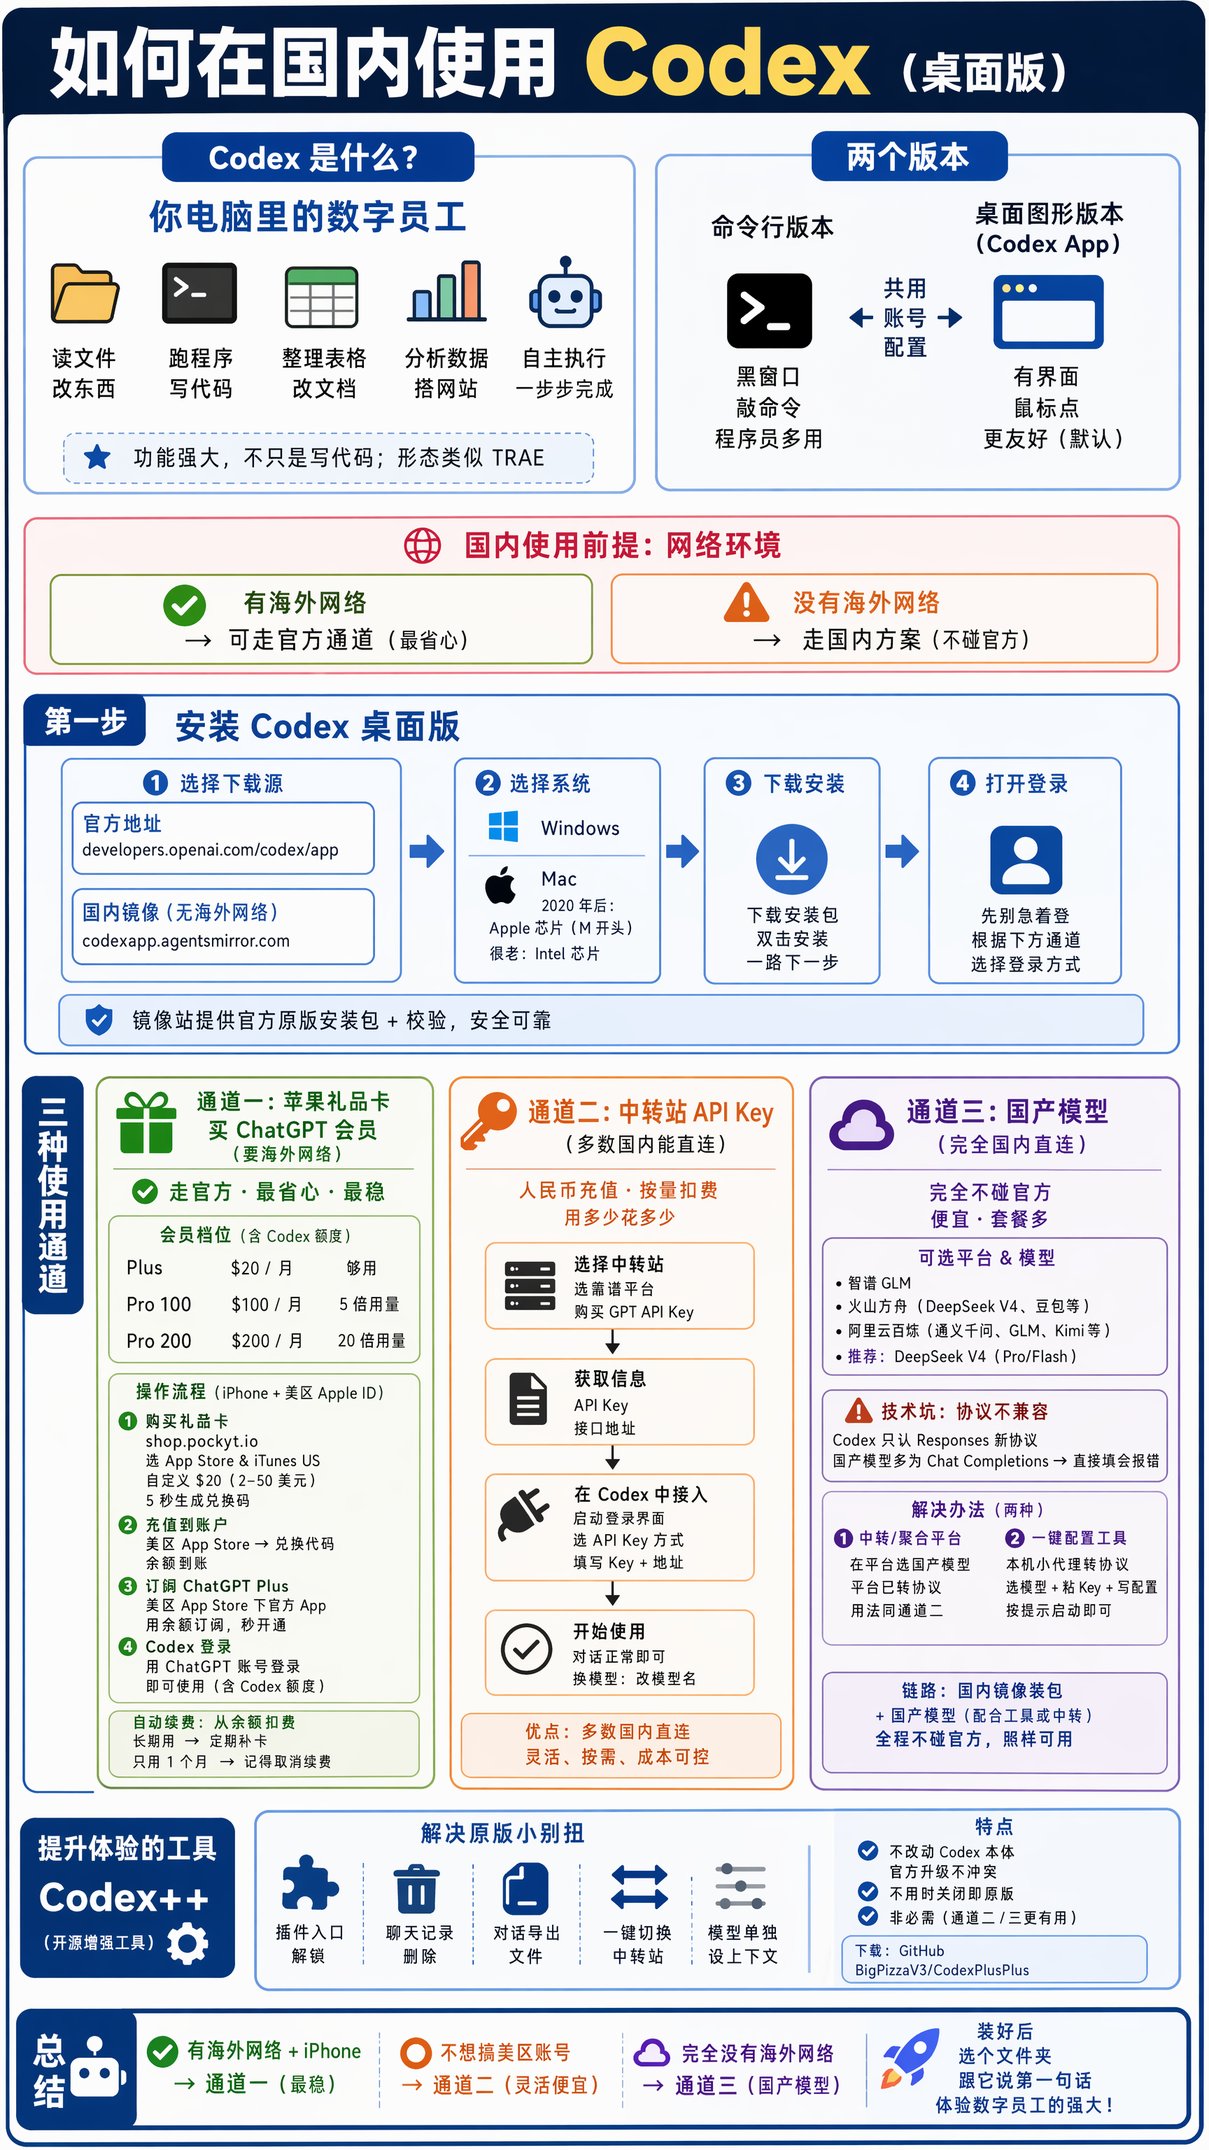
国内用 Codex,最关键的前提是你有没有一个能正常访问海外的网络环境。这篇把有和没有两种情况都讲全,从桌面版怎么装、到怎么买会员、配中转站、用国产模型,一步一步照着做就能跑起来。
