
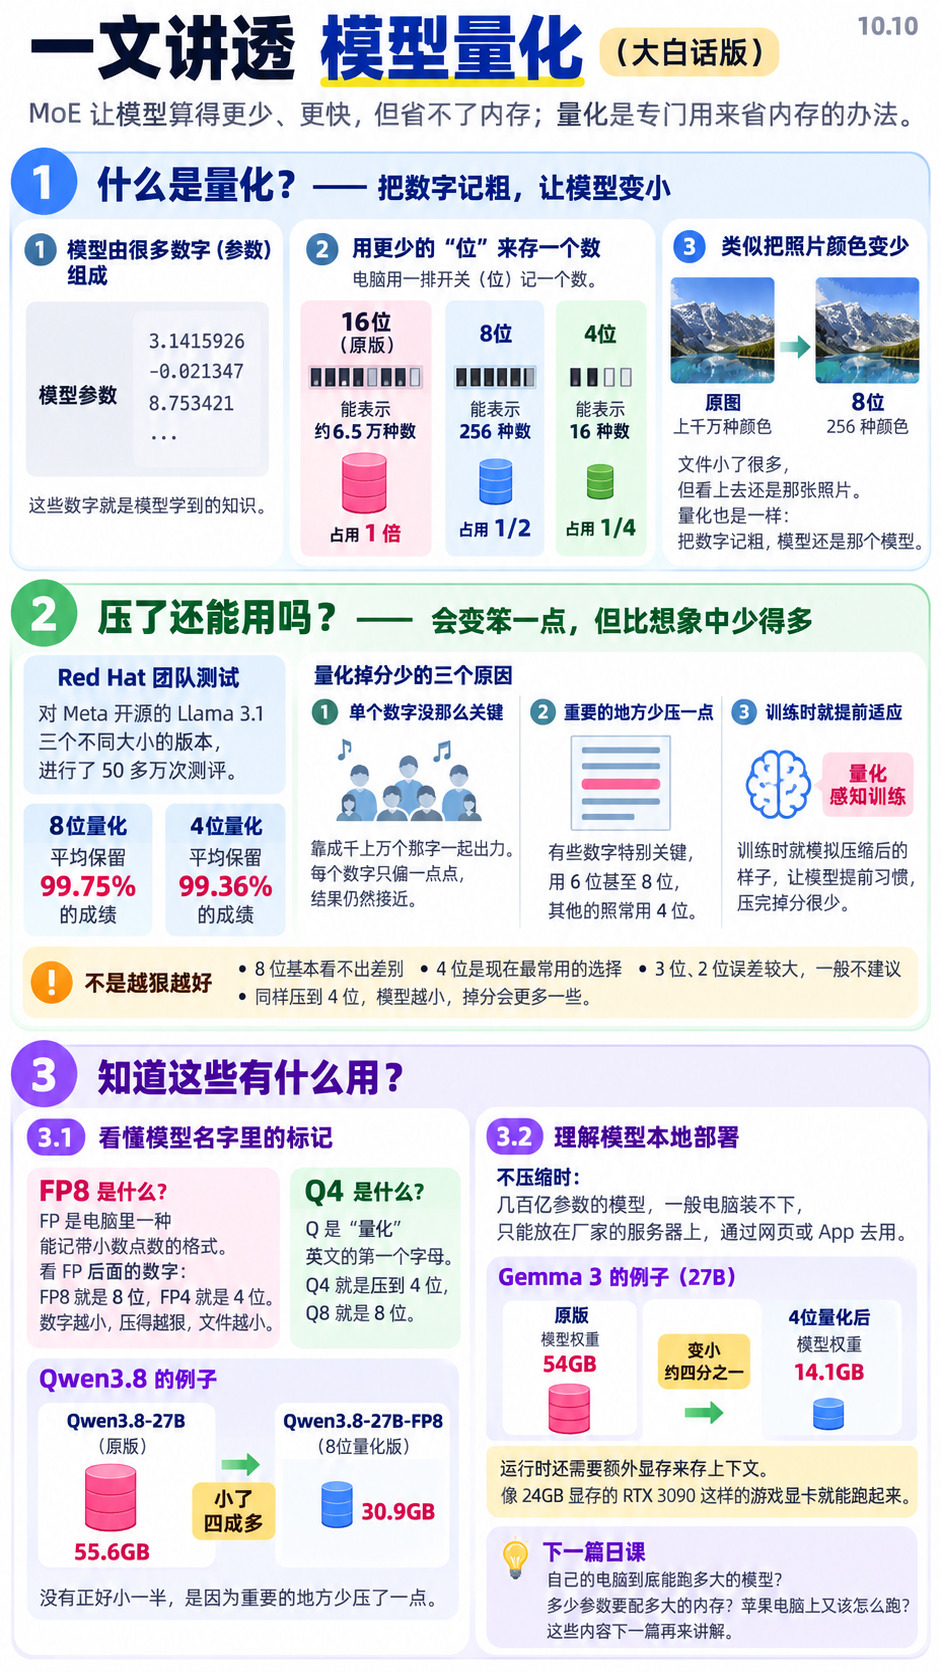
一文讲透模型量化(大白话版)
昨天讲的MoE,可以让模型每次只用一小部分参数,算得更少、更快。但它省不了内存,所有参数还是得一直装着待命。量化,就是专门用来省内存的办法。
AIAI基础知识AI模型GPU谷歌
围绕 AI 工作流、Agent 设计和内容系统的每日更新。
昨天讲的MoE,可以让模型每次只用一小部分参数,算得更少、更快。但它省不了内存,所有参数还是得一直装着待命。量化,就是专门用来省内存的办法。
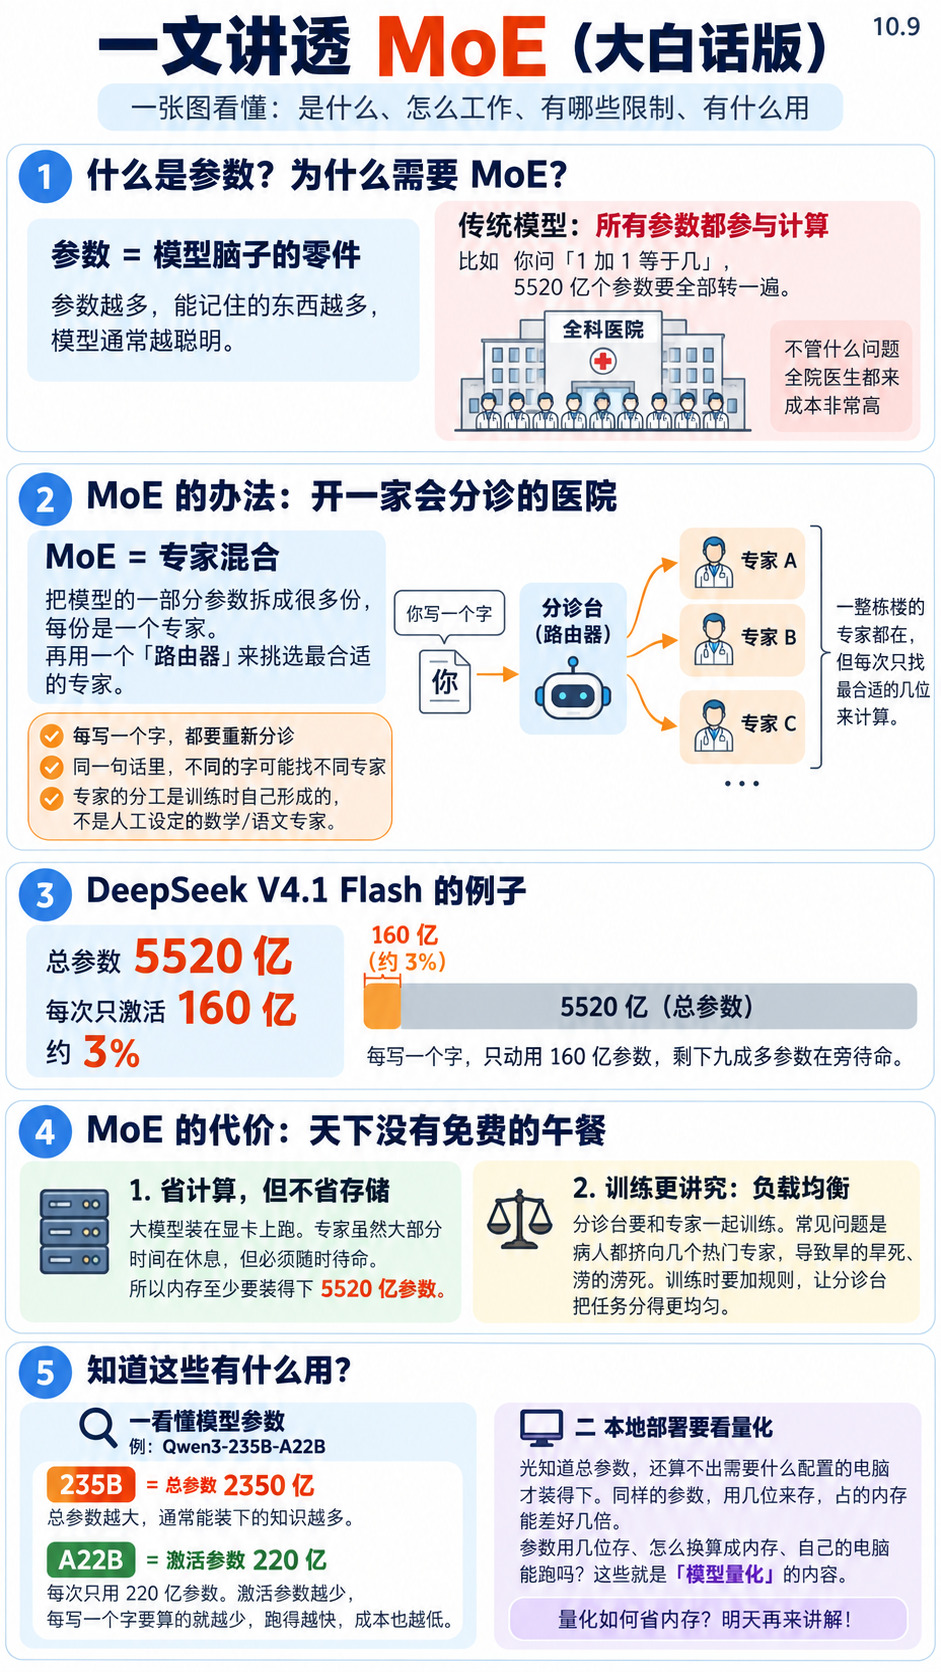
去年 3 月,日课聊过 MoE,也就是专家混合架构。一年多过去,很多人还是不太清楚它到底是怎么回事,今天换个角度,重新讲一遍。
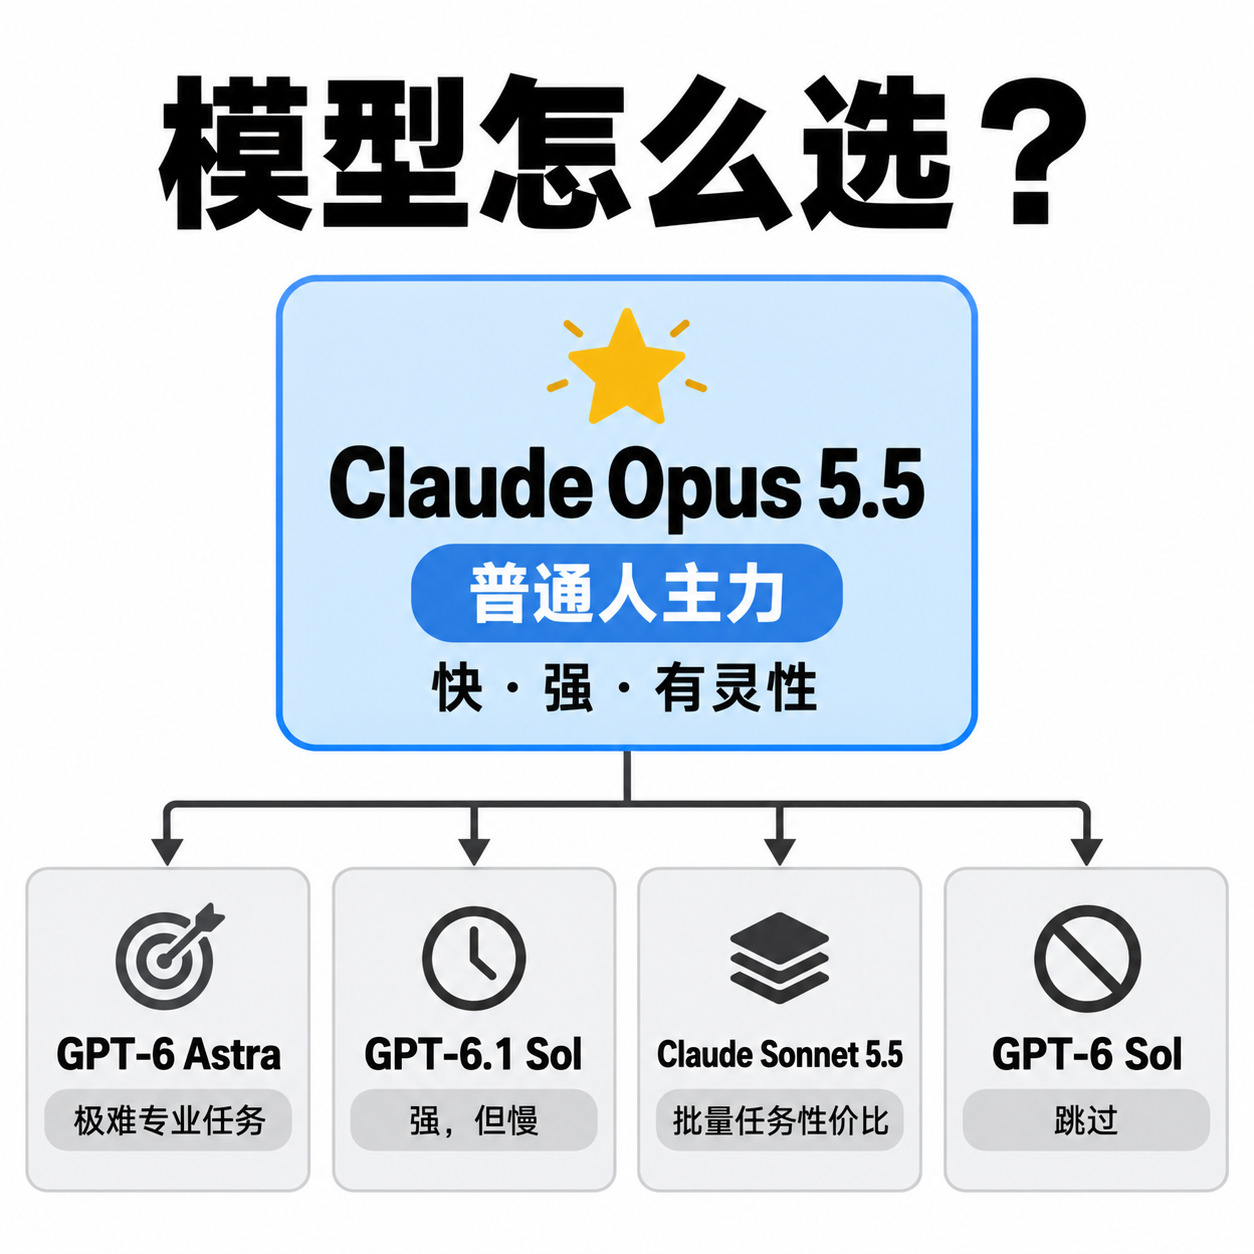
我话就说在这儿了,对于绝大多数人来说现在世界上最好的模型就是 Claude Opus 5.5。
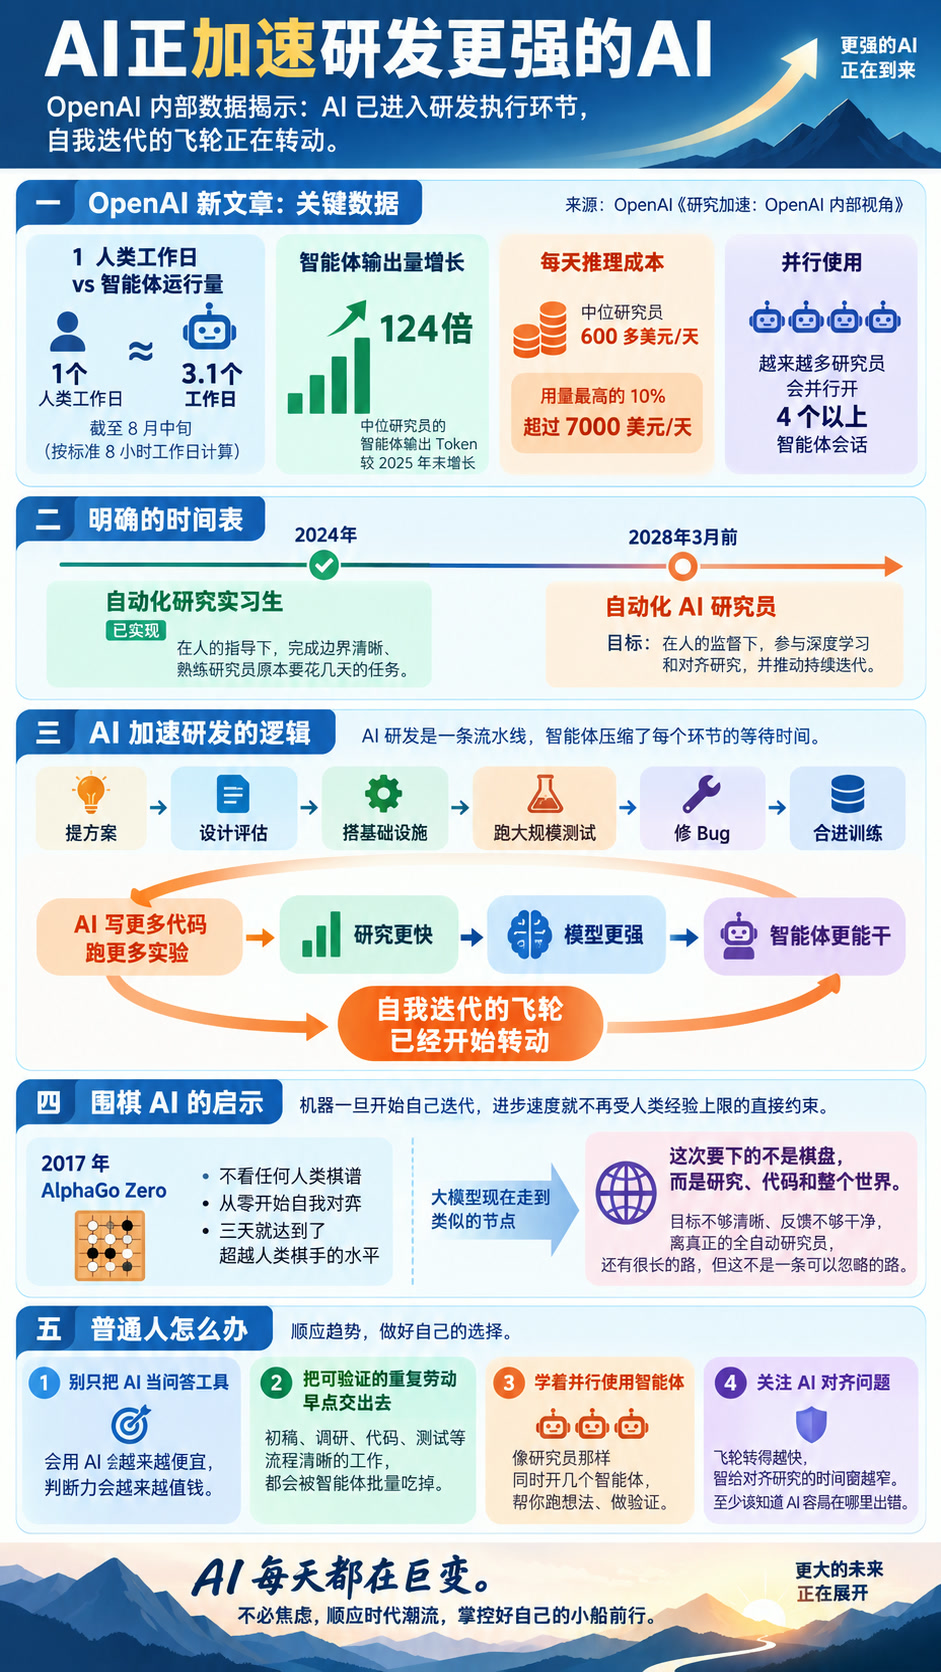
OpenAI公开了一组内部数据:截至8月中旬,研究部门每投入1个人类工作日,智能体已对应3.1个工作日的运行量。完整的递归自我改进尚未发生,但研究闭环的第一段已经开始自动化。
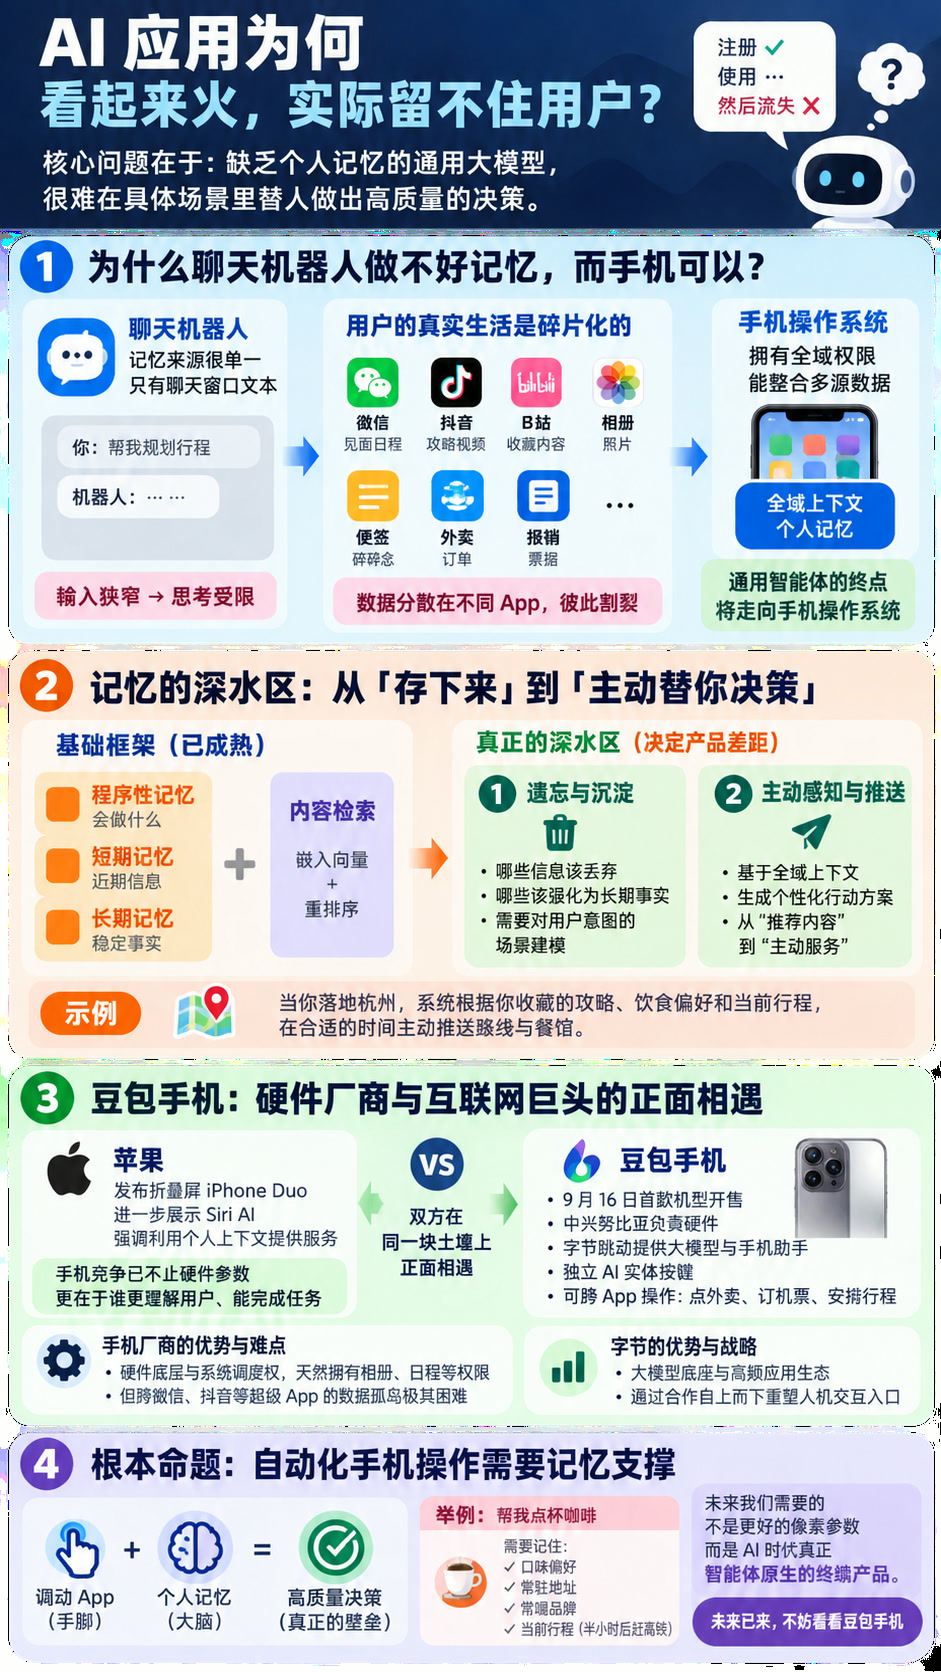
很多号称 AI 原生的产品,看起来门庭若市,实际上注册即流失。核心问题往往不是模型不够强,而是它缺少真正属于你的记忆与上下文。
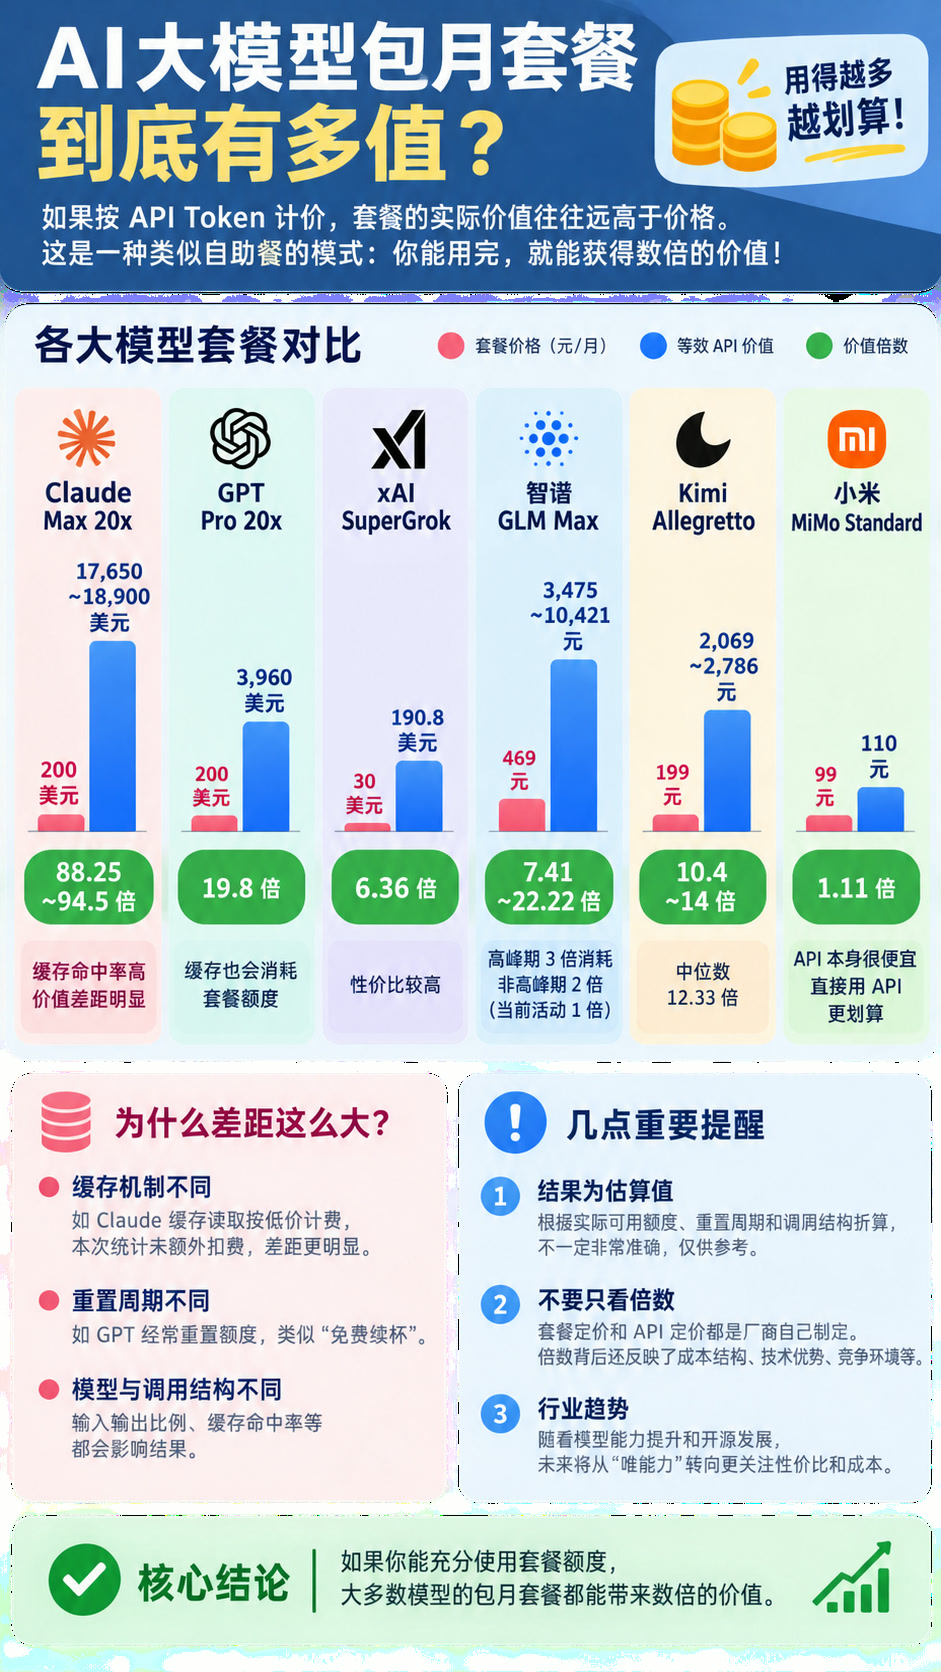
各大模型包月套餐所含的Token量,如果按API Token计价,其价值往往远高于套餐价格。